- Este artículo es la continuación de ‘Domando la caja negra: Enemigos Internos, Fundamentos, Panorama – Un cambio de Paradigma y Kimi’ publicado el 25 de julio de 2026, donde ya anticipaba el colapso de Kimi 3.0 y la necesidad de migrar a modelos locales. Lo que era una alerta entonces, hoy es una realidad.
- Un beneficio de escribir, es documentar. No solo para que otros aprendan, sino para que yo mismo pueda resolver más rápido la próxima vez. Lo que documenté en julio me permitió resolver en dos horas un problema que llevaba quién sabe cuánto tiempo. La documentación no es un lujo. Es una herramienta de trabajo.
Del martes de la semana pasada a hoy hubo tres cosas que pasaron en estos siete días, más una hoy lunes 31, que merecen ser desglosadas poco a poco. Voy a explicar rápidamente el entorno.
- La semana pasada estuve armando tres computadoras muy parecidas de escala media a alta, de 1200 a 1500 USD. Por lo menos es alto para México.
- En general Ryzen 7 5500G o 5500X con 32 GB de RAM, bajo tarjetas RTX Nvidia 5060 Ti Shadow de 16 GB VRAM y RTX Nvidia 5070 de 12 GB VRAM, lo demás igual.
- Me dediqué a hacer pruebas después, y en mi casa, con las computadoras mencionadas.
- El segundo evento es que tuve que ir a ver a un cliente con un problema en una API REST, que no estaba documentada y tenía que ver qué pasaba. El problema era un mal diseño de api y que no estaba documentada, no sabían qué usar, y un problema de hardware también, y lo resolví con Kimi generando unos scripts para testear los dos endpoints, crear un repositorio y documentar lo que hice. En el lugar del cliente tenían muchas computadoras de gama alta…. de esas de 40 a 50 mil pesos, Macs y PC con tarjeta de Video de 12 gb ASUS
Pero lo que pasó hoy fue terrible. El día 26 usé a Kimi.ai como arma secreta para resolver el problema, me tardé unas dos horas y el uso en LLM fue desde una Mac, el uso de consumo era de 0%. Fueron unas dos horas de uso más o menos intenso. Se generaron unos siete archivos y dos o tres pruebas de API, así como un readme.md para un repositorio. Lo importante es 0% de uso y resultados nivel Kimi, espectaculares.
- Nota adicional: Ya había tenido problemas en julio con Kimi hace dos meses por algo parecido. https://vibecodingmexico.com/un-cambio-de-paradigma-y-kimi/
-
Antecedente documentado – No es una queja improvisada, es la continuación de un análisis que empezó en julio.
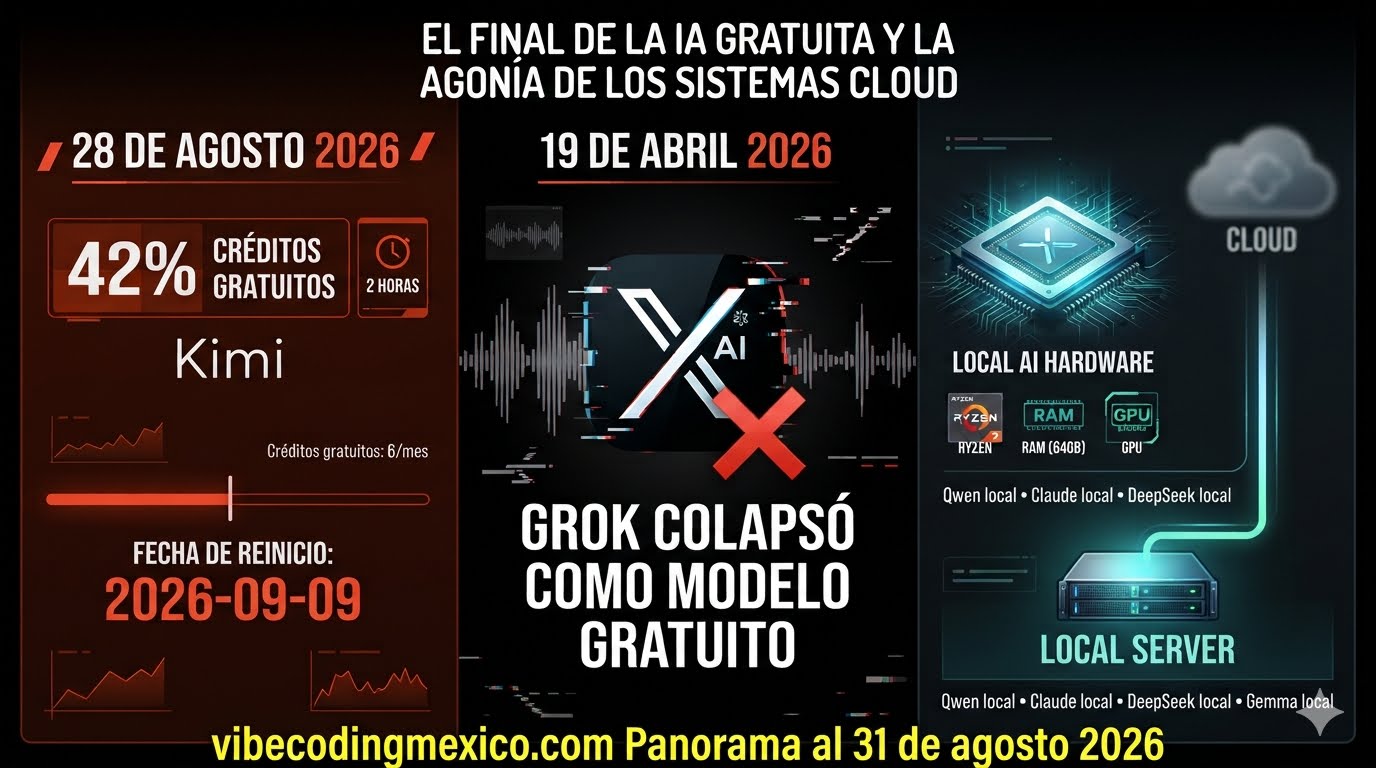
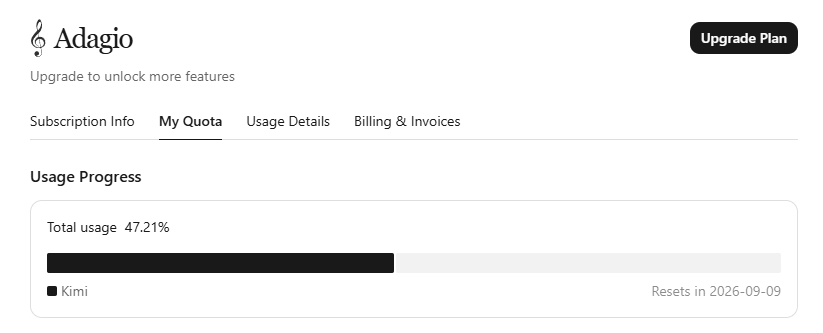
Hoy lunes preparé una serie de hipótesis y hechos de las pruebas de las computadoras. El problema es que al alimentar a Kimi con eso, y detalles del asunto 3 (apis), de repente me dijo que estaba muy ocupado y quiso cambiar a suscripción. Me dijo que había usado el 42% de los créditos y que iba a estar disponible hasta el 9 de septiembre.
Adjunto la imagen
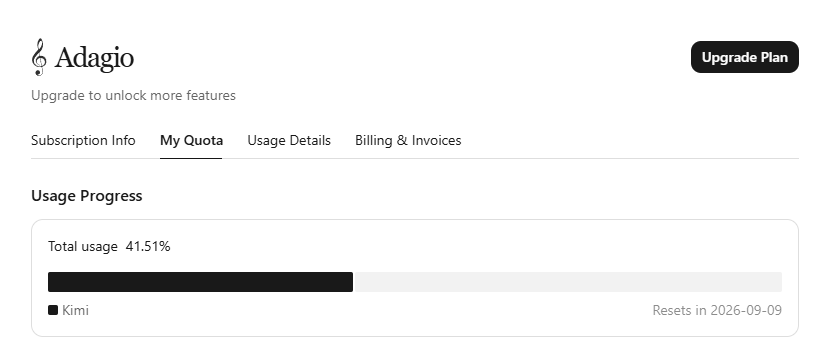
Y se negó a hacerme un resumen. Es decir, en menos de dos horas, donde expliqué el problema de la api y le pregunté si mi solución fue elegante, le sumé tres o cuatro estadísticas sencillas de mi prueba de hardware (punto 2) y obtuve esto.
Así no podemos trabajar.
Mas o menos una hora despues le pedí el resumen de este modo:
- ok, generame dos textos, uno para todo lo que vimos incluyendo las hipótesis y hechos, asi como estas tablas y el segundo para lo que pasó del diagnóstico del api y la persona que buscaba usar chatgpt en un entorno de máquina no controlada. Por favor, que quede listo para copiar y pegar en wordpress.
Si me generó los dos documentos, que no he revisado, pero pasó a 47.21 %
En el reddit de kimi, reddit.com/r/kimi/new/ lo mencionan también :
Kimi now uses credits on regular chats??
byu/United-Project-7648 inkimi
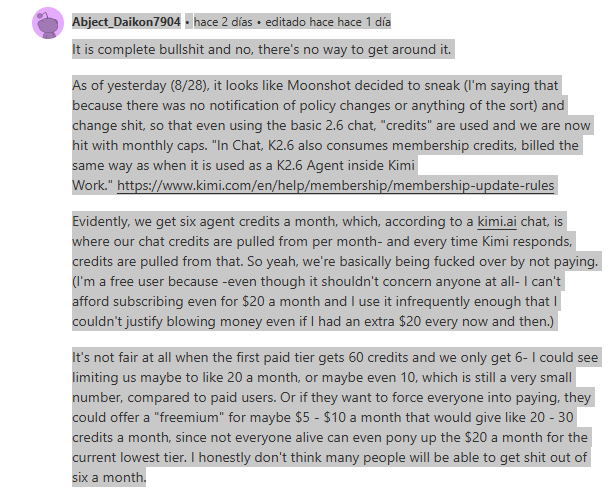
It is complete bullshit and no, there’s no way to get around it.
As of yesterday (8/28), it looks like Moonshot decided to sneak (I’m saying that because there was no notification of policy changes or anything of the sort) and change shit, so that even using the basic 2.6 chat, “credits” are used and we are now hit with monthly caps. “In Chat, K2.6 also consumes membership credits, billed the same way as when it is used as a K2.6 Agent inside Kimi Work.” https://www.kimi.com/en/help/membership/membership-update-rules
Evidently, we get six agent credits a month, which, according to a kimi.ai chat, is where our chat credits are pulled from per month- and every time Kimi responds, credits are pulled from that. So yeah, we’re basically being fucked over by not paying. (I’m a free user because -even though it shouldn’t concern anyone at all- I can’t afford subscribing even for $20 a month and I use it infrequently enough that I couldn’t justify blowing money even if I had an extra $20 every now and then.)
It’s not fair at all when the first paid tier gets 60 credits and we only get 6- I could see limiting us maybe to like 20 a month, or maybe even 10, which is still a very small number, compared to paid users. Or if they want to force everyone into paying, they could offer a “freemium” for maybe $5 – $10 a month that would give like 20 – 30 credits a month, since not everyone alive can even pony up the $20 a month for the current lowest tier. I honestly don’t think many people will be able to get shit out of six a month.
En imagen:
Dicen en otro lugar, no me consta,
- El 28 de agosto de 2026, Moonshot AI generó una fuerte sacudida en la industria con su modelo Kimi K3, pero no por una caída técnica, sino por imponer duras restricciones comerciales y exigencias de infraestructura. La empresa china exigió un 30% de los ingresos a gigantes como Microsoft Azure, AWS y Google Cloud para permitirles alojar su modelo. [1, 2]
- Eso es suicida.
Si el cambio que Moonshot AI implementó el 28 de agosto hubiera estado activo el 26 de agosto, mi experiencia habría sido radicalmente diferente.
Tuve suerte. Por dos días de diferencia, Kimi me salvó el problema. Si hubiera hecho esa misma sesión el lunes 31 (o cualquier día después del 28), me habría topado con el muro de créditos y la historia sería muy distinta.
Y eso es exactamente el futuro cercano: la agonía de los sistemas free no es solo que sean limitados, es que cambian las reglas sin avisar y te dejan tirado justo cuando más los necesitas.
Esa incertidumbre es incompatible con el ser profesional, donde necesitas confiar en que la herramienta va a estar ahí cuando la necesites, sin interrupciones, sin sorpresas, sin que te corten el flujo creativo.
No puedo confiar en Kimi, que era mi modelo principal, pero esto es muy grave. Pasaré a Qwen online, como modelo principal, apoyándome con Claude y DeepSeek para ortografía. Y por cosas que vi en las pruebas de comparación de hardware nvidia, tendré que bajar varias versiones de Gemma4 y Gemma3 para las cosas no código.
Pero como dije en una entrada de hace unas dos semanas, el único otro “power user” que conozco en serio ya dejó de usar la IA por poco fiable. Él dijo: “ya me desesperé”, y en su caso le dan 90% mal. Hoy por ejemplo, al revisar más o menos lo del hardware, Claude confundió procesador Ryzen 5500G con la tarjeta de video, y Kimi ayer se equivocó en bases legales de algo rápido del Código Fiscal de la Federación, sobre la figura de Contador Público Inscrito.
- A mediados de julio hubo otra fallade Kimi a la que llamé “Error dos” , donde se equivocó también Kimi en el CFF, solo que ayer me mezcló CFF con LISR y alucinó varios articulos. También inventó lo que es SIPRED ahace unos días. (Error tres)
- El error cuatro : A mediados de este mes hizo otra cosa similar, 14 de agosto, evento DOS, SIRES
Esto no es un error aislado. Es un patrón.
-
Claude falla en hardware
-
Kimi falla en derecho fiscal básico y alucinó CFF contra LISR… CUATRO OCASIONES DIFERENTES.
- En menos de un mes.
- Lo más grave no es que Kimi haya cometido errores. Lo más grave es que en el último mes ha cometido cuatro errores graves en áreas donde antes era confiable: código, fiscal y normatividad médica. Esto no pasaba antes. Es una degradación real y documentada.
-
Kimi cambia las reglas de uso sin avisar
-
Los modelos libres son cada vez menos fiables que hace meses
Lo que estoy documentando no es solo mi experiencia personal. Es la evidencia de que la IA generativa está entrando en una fase de incompetencia:
Los modelos son impresionantes para tareas generales, pero peligrosamente cada vez más imprecisos .
Esto me lleva a cambiar mi ecosistema.
De manera general:
- Creo que Gemma 3 en 32 GB o en 16 GB funciona decente para no código. Deseables 64 GB.
- Con procesador Ryzen 7 5600G y sin tarjeta de video, Gemma 4 de 8 GB y QSS20 funcionan casi igual que los chats genéricos LLM en sitios web, pero en modo local.
- La tarjeta de video RTX beneficia principalmente a sistemas agenticos.
- El modelo de agentes, arneses y modelos degradados va a tronar más pronto que tarde.
- Hay que respaldar mientras se pueda modelos de menos de 32B. Y digo respaldar porque luego los actualiza LM Studio, me acaba de pasar con un Qwen 30B Coder de hace 200 días, ahora el modelo lo actualizó a uno de hace tres días, no quiero eso. (y en un disco de 480gb son 16 gb desperdiciados tener dos que se llaman igual) Hay que recordar que Nvidia compró Hugging Face.
En resumen además de que tengo que detallar lo de los puntos 1, 2 y 3, mi prioridad es usar Qwen online como principal y empezar a pensar en serio en modo local, aunque eso implique armarme una Ryzen 9 con 64 GB, porque los modelos libres LLM de chat cada vez son menos y menos fiables que sus resultados de marzo de este mismo año.
De momento, la prioridad que veo en hardware para usuarios nuevos es:
- Armadas, no Mac, laptop ni all-in-one, por calentamiento.
- No hay en México fácil de marca. Dell ya no está en México y HP es pésima en compatibilidad de memoria de dos pc compradas al mismo tiempo, Lenovo es de mala calidad.
- Con DDR4 / socket AM4. La diferencia de AM5 y DDR5 es brutal.
- 16 GB de RAM, en una PC estable.
- Procesador Ryzen 7 5600X, que debe ser aprox la máquina por 10000 con poca memoria.
- Actualizar a 1 TB desde 480 GB SSD son 500 pesos.
- La diferencia de Ryzen 5 a Ryzen 7 son 1000 MXN. Compra Ryzen 7 5600X o 5600G desde el principio.
- Parece que hay mucha importancia en modelos locales a la RAM que tienes disponible después del procesador. Así que:
- En cuanto se pueda, cambiar a 64 GB de ram.
- Y solo entonces tarjeta de video, en mi caso RTX 5070 de 12 GB estaba a 12450 MXN, y RTX 5060 Ti Shadow de 16 GB a 12950, 500 pesos de diferencia.
La máquina base que sugiero es de 12000 a 15000 con 32 GB, y otros 12 a 14 para tarjeta de video y enfriador.
En estos días desgloso los tres puntos que comenté al principio.
El final de Kimi y la agonía de los sistemas free me recuerdan una lección dura: no puedes depender de lo que no controlas. Mi ecosistema va a cambiar radicalmente. Más local, menos nube. Más certeza, menos sorpresas.
Voy a bajar de LM Studio dos modelos LLM de Kimi 2.6 de menos de 30 gb para tenerlos como reserva. Los problemas han sido de kimi 3.0 Modo Online.
Nota : La imagen la generé con una técnica mixta entre deepseek y gemini haciendo que ellos me dieran las dos fechas que yo ya sabía.