Benchmarks Locales con LLMs: ¿Vale la pena una RTX 5060 Ti 16 GB en 2026?
Fecha: Agosto 2026 | Ubicación: México
Este artículo resume Semanas de pruebas reales corriendo modelos de lenguaje grandes (LLMs) en hardware accesible. No hablamos de teoría: hablamos de tiempos de espera reales, pesos de modelos, cuantizaciones y decisiones de compra que cualquier desarrollador o consultor enfrenta hoy.
EL resumen fue hecho por KIMI pero el punto TRES, de razones para comprar 64 gb no lo evaluó Kimi por problemas de su cuota de uso, ese punto se hizo con Claude. Este es un análisis con datos proprocionados por humano, yo.
1. Hechos confirmados
- H1: En México (agosto 2026), el DDR4 sigue siendo más barato que el DDR5.
- H2: Los procesadores más equilibrados en experiencia propia son el Ryzen 7 5500G y el 5500X; cuando no hay stock del segundo, se usa el primero.
- H3: Las placas base usadas soportan al menos 64 GB de RAM; la configuración estándar de prueba usa 32 GB instalados.
- H4: Las máquinas de prueba fueron:
- Máquina A (antigua): Intel Core i5-7400 (7ª generación, ~10 años de antigüedad), 32 GB RAM Kingston Fury.
- Máquina B (moderna): AMD Ryzen 7 5500G + 32 GB RAM + NVIDIA RTX 5060 Ti 16 GB GDDR7 (MSI Shadow 2X OC).
2. Hipótesis planteadas
- No todos pueden comprar una PC con GPU de 16 GB de una sola vez, pero es factible hacerlo en dos partes: primero la base (~$6,000–$8,000 MXN) y luego la tarjeta de video (~$14,950 MXN aproximadamente).
- Si no puedes gastar al menos ~$700 USD en una PC propia, no es que estés “mal”, pero estás en problemas. Este equipo de 700 USD es una situación similar a quien en 1991 usaba una 286: Ese equipo te costaba 700 USD. Era funcional para lo básico, fuera del ultimo grito de la moda pero era herramienta sólida. Es el mismo estándar productivo actual. Puedes hacer algo pero si no puedes dedicar 700 USD hay un problema mayor. Y los 700 USD ahora son Ryzen 7 con 16 a 32 gb.
- No siempre conviene migrar a Linux porque puedes perder (o complicar) la licencia de Windows 10/11, especialmente en entornos corporativos o de consultoría.
- Aun con 16 GB de VRAM no puedes cargar todos los modelos; el Qwen3-30B-A3B en Q4 pesa ~18 GB y no cabe completo.
- El disco duro es limitado. Debes decidir que estás haciendo en el SSD
- El mayor desempeño de la tarjeta de video se ve en sistemas agenticos (coding, iteración rápida, múltiples pasos). Sin GPU, una PC de ~$15,000 MXN con Ryzen 7 y 32 GB sigue siendo útil por relación costo-beneficio para chat y diagnóstico.
- Instalar 64 GB de RAM de entrada puede ser el mayor incremento de rendimiento por bajo costo, aunque el conocimiento tradicional dice que solo valen para máquinas virtuales o edición 4K. El 90 % de los usuarios no entrenará modelos, pero 64 GB previene aumentos de precio y problemas de compatibilidad de memoria en el futuro. (Esto lo refino mas adelante en 3, porqué 64 GB de ram)
- Para alguien de bajo presupuesto, lo más importante es al menos un Ryzen 7 en equipo armado (Ryzen 5 no se recomienda salvo casos extremos), con un mínimo de 16GB de RAM por cuestiones de Ollama bajo Linux y desempeño general en Windows 10/windows11.
3. Por qué 64GB de RAM, aunque no se vaya a hacer fine-tuning
El argumento tradicional dice que 64GB solo se justifican para máquinas virtuales pesadas, edición de video 4K o servidores locales no para uso de LLMs, donde el recurso que importa es la VRAM de la GPU, no la RAM del sistema.
Ese argumento sigue siendo válido para entrenamiento o fine-tuning. Pero el escenario que se viene no es ese: es el usuario común, el 90% que nunca va a entrenar un modelo, que necesita modo chat local como respaldo o como opción principal cuando las cuotas en línea dejen de ser viables. En ese escenario, 64GB de RAM cumple una función distinta:
- Permite cargar modelos más grandes en modo chat sin depender exclusivamente de la GPU.
- Da margen para tener el sistema operativo, el navegador y el modelo corriendo a la vez sin que el swap se vuelva el cuello de botella.
- Funciona como colchón ante alzas de precio o cambios de tipo de memoria (DDR4 a DDR5) que puedan encarecer una ampliación posterior.
Y en realidad si vi un mayor desempeño por procesador y memoria, que no era atribuible a la RTX sino a una pc con mas GB de ram.
- Nota: Es decir, una base de 14000 + 32 gb extras de ram puede ser mejor rendimiento para muchos que 15000 En una tarjeta de Video RTX con 16 gb de VRAM
- Poner de entrada 64 gb te ayuda, es barato y te previenes contra aumentos de precio e incompatibilidades entre los dimms de memoria.
- Y la tarjeta RTX la puedes poner después.
Es una inversión de bajo costo relativo con beneficio inmediato en estabilidad, incluso si nunca se usa para entrenar nada.
¿Y la tarjeta de video grande? Depende del modo de uso
Aquí es donde los propios datos del benchmark “koala” son la mejor evidencia:
- En modo chat, el Intel i5-7400 sin GPU completó la prueba de Qwen3-30b-a3b en 12 minutos — más lento que la máquina con RTX 5060 Ti (2.5 minutos con offload por defecto), pero la completó. Para una consulta de chat que no es interactiva en tiempo real, esa diferencia de minutos es tolerable.
- El offload de GPU no mostró un beneficio lineal: 48% de offload dio peor tiempo (8.57 min) que 30% por defecto (2.5 min), señal de que el cuello de botella real está en cómo el modelo reparte memoria entre VRAM y RAM, no en la potencia bruta de la tarjeta.
- Los modelos que mejor aprovecharon la GPU (GPT-OSS 20b, Qwen3-30b-coder) fueron precisamente los que requieren menos offload — es decir, el beneficio de una GPU de 16GB se nota más en cargas de trabajo agénticas (donde hay ejecución de herramientas, iteración y contexto extendido en tiempo real) que en el flujo simple de pregunta-respuesta.
Conclusión práctica: una GPU de 16GB de VRAM (~14,950 MXN, casi el costo de la PC completa) solo se justifica económicamente si hay una intención real de trabajar en modo agéntico — automatización, herramientas encadenadas, uso productivo constante. Para quien solo necesita un respaldo de chat ante la contracción de las cuotas gratuitas, esa inversión no es costeable frente al beneficio real que aporta.
4. Resultados de benchmarks reales
4.1 El “koala”: generación de código PHP (prompt estándar)
| Modelo | Tamaño Q4 | Configuración GPU | Tiempo | Observación |
|---|---|---|---|---|
| GPT-OSS 20B | ~12 GB | 100 % offload (cabe en 16 GB VRAM) | 25 segundos | Velocidad nativa GDDR7. Transformacional. |
| Gemma 4 E4B | ~6.33 GB | 100 % offload | < 1 minuto | Coder denso pequeño, muy eficiente. |
| Qwen3-30B-A3B Q4 | ~18 GB | 30 % offload (punto dulce) | 2.5 minutos | MoE no cabe completo. Parcial offload óptimo. |
| Qwen3-30B-A3B Q4 | ~18 GB | 48 % offload (saturado) | 8.57 minutos | “Valle de la muerte”: VRAM llena + tráfico PCIe. |
| Qwen3-30B-A3B Q4 | ~18 GB | 7 % offload | 4 minutos | GPU casi inactiva, todo por CPU. |
| Qwen3-30B-A3B Q4 | ~18 GB | 0 % offload (CPU pura, i5-7400) | 12 minutos | Esperable para un 4C/4T de 2017. |
4.2 La lección del “valle de la muerte”
Con modelos MoE (Mixture of Experts) como Qwen3-30B-A3B, el partial offloading intermedio puede ser peor que correr todo en CPU. Cada token activa expertos dispersos por todo el modelo; si las capas están repartidas entre GPU y CPU, el tráfico por el bus PCIe destruye cualquier ganancia.
Regla de oro: con una GPU de 16 GB, si el modelo no cabe completo, no subas el offload más allá del punto dulce (~30 % en este caso). Mejor baja la cuantización a Q3_K_M (~14 GB) para que quepa entero y vuele.
5. Comparativa de modelos coder que SÍ caben en 16 GB VRAM
| Modelo | Parámetros | VRAM Q4_K_M | ¿Cabe en 5060 Ti? | HumanEval |
|---|---|---|---|---|
| GPT-OSS 20B | 20B MoE | ~12 GB | ✅ Sí | Competitivo |
| Qwen2.5-Coder-14B | 14.7B denso | ~9.5 GB | ✅ Sí | 89.6 % |
| Codestral 22B | 22.2B denso | ~14 GB | ✅ Sí | Especialista FIM |
| Devstral Small 24B | 24B denso | ~15 GB | ✅ Sí | Agentic coding |
| Qwen3-14B | 14.8B denso | ~9 GB | ✅ Sí | Thinking switchable |
| Qwen3-30B-A3B Q4 | 30B MoE | ~18 GB | ❌ No | Necesita Q3 o más VRAM |
6. Conclusiones prácticas
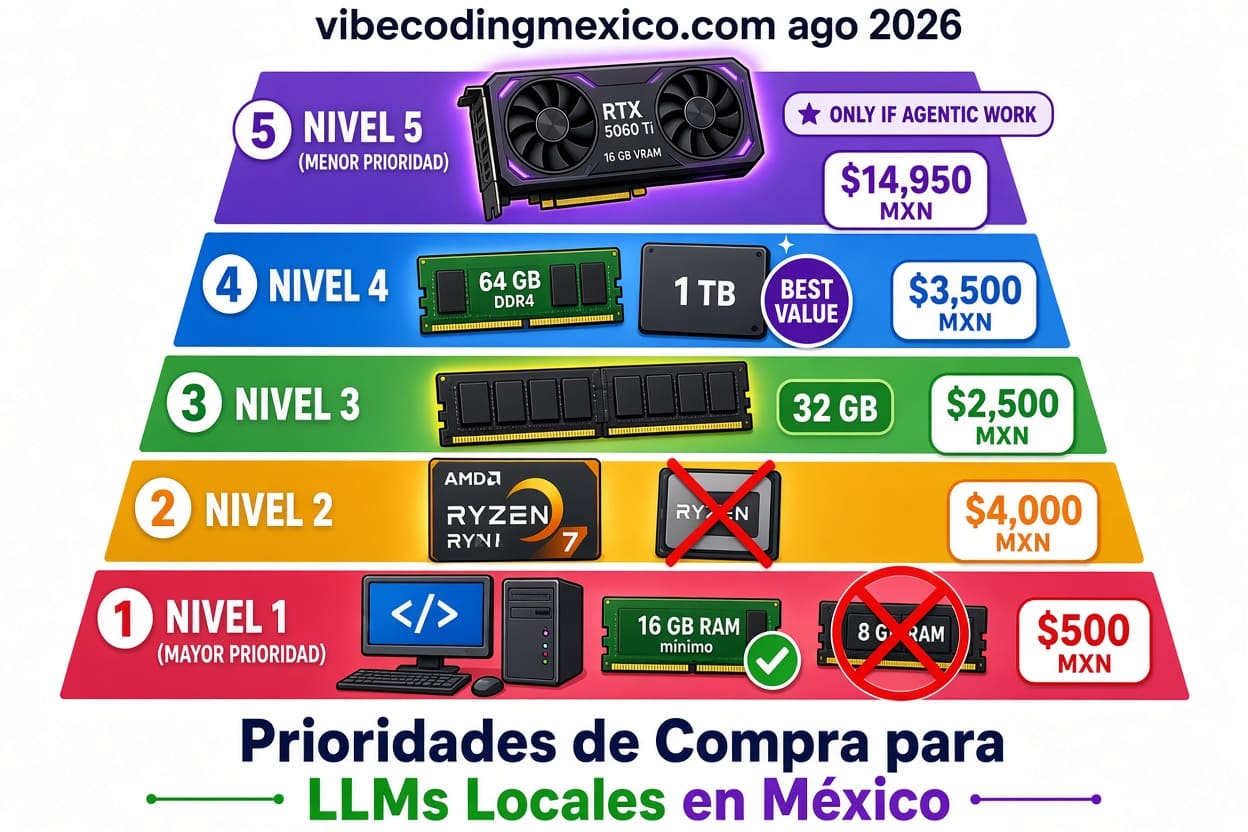
La prioridad está pensada para entorno económico de México para alguien que quiere usar con LLMs locales, pero con presupuesto ajustado.
6.1 Sobre el hardware, por temperatura debe ser Desktop armado
- Prioridad 1: Mínimo 16 GB de RAM. Con 8 GB en Windows 11 no hay vida útil para nada serio.
- Prioridad 2: Un Ryzen 7 5700X (o 5500G) es el piso recomendable. La diferencia de precio contra un Ryzen 5 es de apenas ~$1,000 MXN y los cores/hilos extra se notan en inference.
- Prioridad 3: 32 GB de RAM DDR 4 si vas a tocar LLMs locales siquiera ocasionalmente.
- Prioridad 4: Aunque suene excesivo, 64 GB de RAM y subir a un tb el disco de 480 GB. Lo necesitas para espacio de modelos.
- Prioridad 5: La GPU de 16 GB es un acelerador, no un requisito. Brilla cuando el modelo cabe completo en VRAM (GPT-OSS 20B, Gemma 4, Codestral 22B). Cuando no cabe, el partial offload puede ser contraproducente.
- Y la memoria la puedes poner después
6.2 Sobre la estrategia de compra
La compra en dos fases es la más inteligente para presupuestos ajustados:
- Fase 1: Gabinete + Ryzen 7 + board + 32/64 GB DDR4 + fuente (~$10,000–$14,000 MXN). Ya puedes trabajar: chat en la nube, diagnósticos, scripting, modelos pequeños en CPU.
- Fase 2: RTX 5060 Ti 16 GB (~$14,950 MXN). Ahora sí: coding agentico, iteración rápida con modelos 20B–24B, productividad multiplicada. Suma 1350 MXN por Sistema de enfriamiento y asegurate de tener fuente de 850 W.
6.3 Sobre el “chat vs. agente”
| Modo de uso | Hardware mínimo recomendado | ¿GPU necesaria? |
|---|---|---|
| Chat con IA en la nube (ChatGPT, Claude) | Ryzen 5 + 16 GB RAM | ❌ No |
| LLMs locales ocasionales (7B–14B) | Ryzen 7 + 32 GB RAM | ❌ No, pero ayuda |
| Coding iterativo, generación de código | Ryzen 7 + 32 GB RAM + GPU 12 GB | ✅ Sí, si quieres velocidad |
| Agentes multi-paso, análisis complejos | Ryzen 7 + 64 GB RAM + GPU 16 GB | ✅ Sí, indispensable |
7. Nota final y Resumen
Conclusión práctica: una GPU de 16GB de VRAM (~14,950 MXN, casi el costo de la PC completa) solo se justifica económicamente si hay una intención real de trabajar en modo agéntico : automatización, herramientas encadenadas, uso productivo constante. Para quien solo necesita un respaldo de chat local ante la contracción de las cuotas gratuitas, esa inversión no es costeable frente al beneficio real que aporta.
Resumen
| Objetivo del usuario | RAM recomendada | ¿GPU grande (16GB VRAM)? |
|---|---|---|
| Chat local como respaldo ante límites de cuotas gratuitas | 64GB | No es prioritario — el CPU solo, con paciencia, cumple |
| Trabajo agéntico real (herramientas, automatización, uso productivo constante) | 32–64GB | Sí — es donde el offload y la VRAM sí se traducen en tiempo útil |
La prioridad de gasto para el usuario que solo necesita cubrirse ante la contracción de los modos gratuitos no es la tarjeta de video: es la RAM. La GPU se paga sola únicamente cuando el uso justifica el modo agéntico — y para la mayoría de los usuarios en México, ese no es todavía el caso.
Los benchmarks fueron ejecutados con LM Studio como backend por ser la opción más accesible para usuario promedio. Los tiempos pueden variar con llama.cpp nativo, Ollama u otros backends, pero las proporciones y conclusiones se mantienen.
- Todo se hizo en frio, sin estar abiertas pestañas de navegador. Sistema operativo acabado de instalar.
Hardware probado: Intel i5-7400 / 32 GB DDR4; AMD Ryzen 7 5500G / 32 GB DDR4 / NVIDIA RTX 5060 Ti 16 GB GDDR7. México, agosto 2026.
Imagen hecha con Grok con este prompt de Deepseek:
- A colorful flat vector cartoon illustration of a 5-level priority pyramid for computer hardware purchases in Mexico. At the bottom (highest priority): a computer with “16 GB RAM mínimo” and a crossed-out 8 GB RAM stick. Level 2: an AMD Ryzen 7 processor box with a Ryzen 5 crossed out next to it. Level 3: two DDR4 RAM sticks labeled “32 GB” with a subtle glow. Level 4: a large RAM module labeled “64 GB DDR4” and an SSD labeled “1 TB” with a “BEST VALUE” badge. Level 5 (top, lowest priority): an NVIDIA RTX 5060 Ti graphics card with 16 GB VRAM, glowing but isolated, with text “ONLY IF AGENTIC WORK”. Mexican peso price tags on each level: $500, $4,000, $2,500, $3,500, $14,950 MXN. Bottom text: “Prioridades de Compra para LLMs Locales en México”. Style: flat vector cartoon, colorful, clean composition, tech blog aesthetic, white background, 16:9 aspect ratio. No extra text.